Explicador interactivo · Banca e infraestructura de IA
GPU para la banca IA dentro de casa
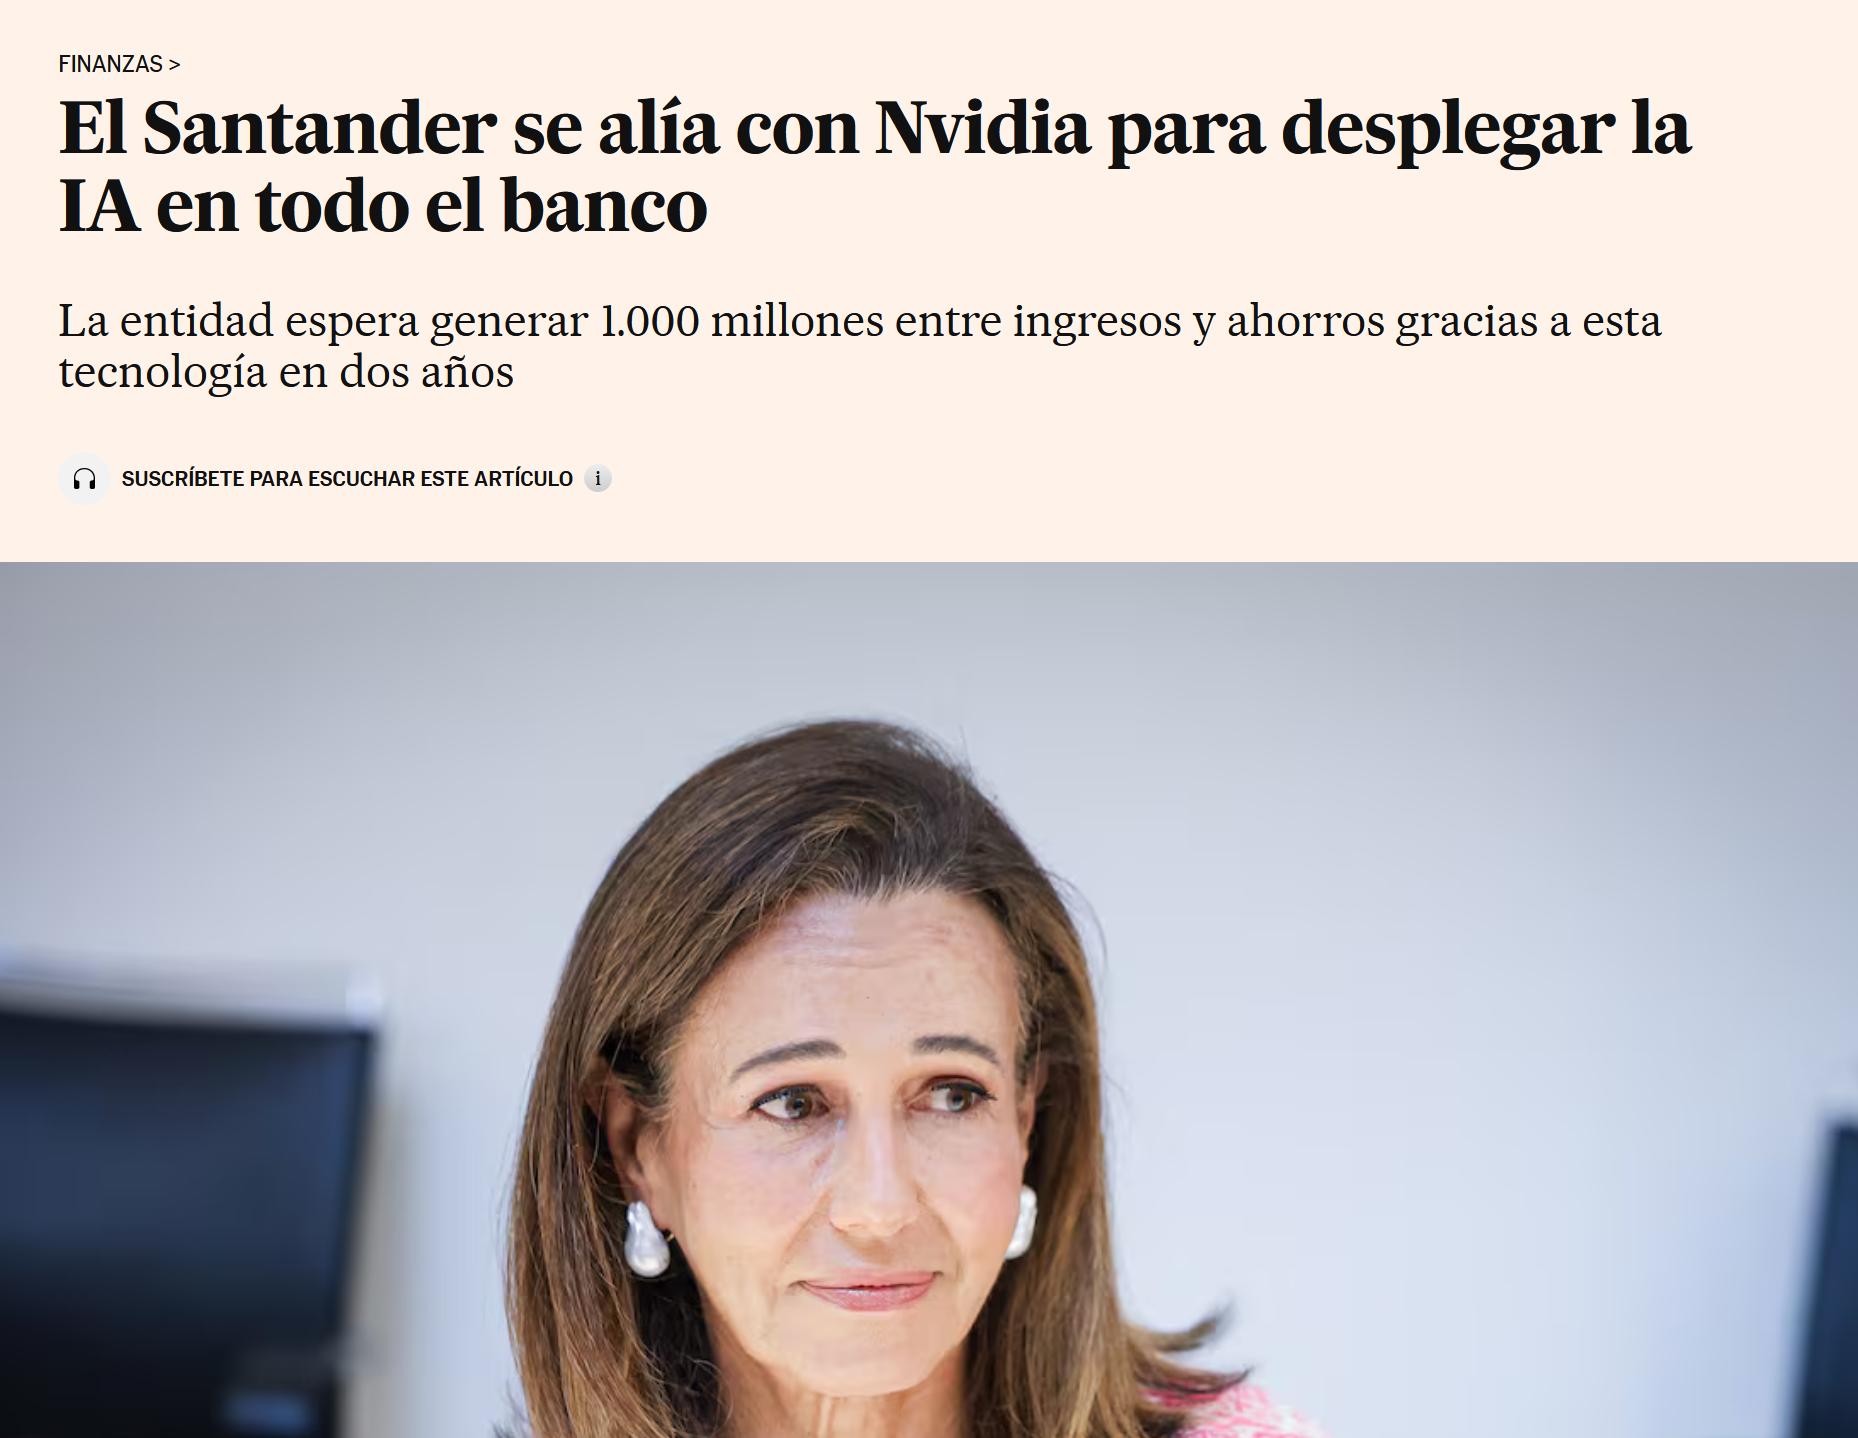
Noticia de contexto: «El Santander se alía con Nvidia para desplegar la IA en todo el banco». Captura aportada.
Un modelo de IA propio no es un programa que se instala: es un cálculo gigantesco que hay que ejecutar una y otra vez, dentro del perímetro del banco. Esta página te deja tocar los números para que veas de dónde sale la necesidad de hardware.
EXPLORA¿Por qué necesita tantas GPU un banco que ejecuta IA en sus propios centros de datos? Compara CPU y GPU, cambia el tamaño del modelo y explora el entrenamiento, la memoria y la demanda. Las cifras son supuestos didácticos, no datos de una entidad concreta.
ESTACIÓN 01
Un modelo de IA es, sobre todo, multiplicar matrices
Cada palabra que genera un modelo de lenguaje requiere miles de millones de multiplicaciones y sumas. Son operaciones sencillas, pero muchísimas y todas iguales.
Una CPU tiene pocos núcleos muy listos (decenas), pensados para tareas distintas una detrás de otra. Una GPU tiene miles de núcleos sencillos que hacen la misma operación a la vez. Para multiplicar matrices, eso es exactamente lo que hace falta.
Pulsa «Ejecutar» y mira cuántos ciclos tarda cada una en procesar el mismo bloque de 256 operaciones.
Carrera: 256 operaciones idénticas
CPU8 núcleos · 8 ops/ciclo
0ciclos
GPUmiles de núcleos · 64 ops/ciclo (escalado)
0ciclos
En la realidad la diferencia es mayor: una H100 ejecuta cerca de 10¹⁵ operaciones de coma flotante por segundo en precisión reducida; un servidor de CPU de gama alta, unas 10¹³. Aquí la animación está escalada para que se pueda ver.
ESTACIÓN 02
Tres formas de desplegar IA
«Crear un modelo on‑premise» significa que el banco entrena (o ajusta) y ejecuta el modelo en sus propios centros de datos, con hardware que compra, en lugar de enviar los datos a un proveedor externo.
Compara las tres vías. Fíjate en dónde se queda el dato del cliente y quién controla las GPU.
PERÍMETRO DEL BANCO
Datos de clientes
Transacciones
Riesgo y crédito
Clúster GPU propio
Modelo entrenado
— los datos no salen —
FUERA DEL BANCO
GPU de un hiperescalador
Modelo de un tercero (API)
ESTACIÓN 03
Cuatro razones por las que un banco quiere las GPU dentro
Para una startup, alquilar GPU en la nube es lo normal. Para un banco sistémico europeo con cientos de millones de clientes, las cuentas y las reglas cambian. Pulsa cada razón para desplegarla.
ESTACIÓN 04
Entrenar: la aritmética que obliga a comprar más GPU
Hay una regla práctica para estimar el coste de entrenar un modelo de lenguaje:
FLOPs ≈ 6 × parámetros × tokens de entrenamiento
Cada parámetro «ve» cada token unas seis veces entre el paso hacia delante y el de aprendizaje. Si divides ese total entre lo que rinde tu clúster por segundo, obtienes cuánto tardará. Mueve los controles: verás cómo añadir GPU reduce el tiempo estimado, manteniendo los demás supuestos.
Las GPU nunca rinden al 100 %; el cálculo usa un aprovechamiento real (MFU) del 40 %.
Tipo de GPU:
Cálculo totaloperaciones (FLOPs)
Tiempo de entrenamiento
Energía consumida
ESTACIÓN 05
Memoria: un modelo serio no cabe en una sola GPU
Aunque tuvieras paciencia infinita, hay un segundo muro: la memoria. Cada parámetro ocupa 2 bytes en precisión FP16 solo para guardarlo. Para entrenarlo hacen falta además los gradientes y los estados del optimizador: unos 16 bytes por parámetro, más las activaciones.
Una H100 tiene 80 GB; una B200, 192 GB. El modelo hay que trocearlo entre muchas GPU que se hablan a velocidades enormes (NVLink, InfiniBand). Por eso Nvidia no vende solo chips: vende el sistema completo.
Memoria para inferencia (pesos FP16)
Memoria para entrenamiento (pesos + gradientes + optimizador + activaciones)
PesosGradientesOptimizadorActivaciones
H100 mínimas · inferenciade 80 GB
H100 mínimas · entrenarsolo para que quepa
B200 mínimas · entrenarde 192 GB
Cada cuadrado es una H100 necesaria solo para alojar el entrenamiento:
ESTACIÓN 06
Servir el modelo a millones de clientes: la factura que no para
Entrenar se hace unas pocas veces. Inferir (responder a cada consulta) se hace millones de veces al día, para siempre. En un banco con millones de clientes, si una parte usa un asistente a diario, la demanda en hora punta se mide en miles de respuestas por segundo.
Cada GPU puede generar un número limitado de tokens por segundo con un modelo grande. Ajusta la demanda y mira cuántas GPU hacen falta solo para inferencia, sin contar las de entrenamiento.
Tokens/s en picoque hay que generar
GPU para inferenciamodelo 70B · ~2.500 tok/s por GPU
Con redundancia+30 % (N+1, mantenimiento, 2 CPD)
ESTACIÓN 07
Síntesis: «más GPU» porque todo se suma
El clúster de un banco no es un solo modelo entrenado una vez. Es una fábrica de IA que trabaja a la vez en varias líneas, y cada una pide su parte del hardware. Ese reparto aproximado explica por qué el número final siempre es mayor de lo que sugiere cualquier cálculo aislado.
Eso ayuda a entender el papel de un proveedor de infraestructura: a esta escala, lo difícil no es tener chips, sino conectarlos, programarlos y operarlos como una sola máquina.
A qué se dedican las GPU de un banco (reparto ilustrativo)
Lo que aporta el socio además de las tarjetas
InterconexiónNVLink / NVSwitch e InfiniBand para que cientos de GPU actúen como una sola memoria.
SoftwareCUDA, TensorRT, NIM y frameworks para entrenar y servir sin reescribir todo.
Sistemas llave en manoDGX / SuperPOD: racks, refrigeración y red diseñados juntos.
Soporte y hoja de rutaAcceso prioritario a nuevas generaciones en un mercado con escasez.
COMPRUEBA LO APRENDIDO
Tres preguntas rápidas
Cifras orientativas para fines didácticos: rendimiento FP16 denso de H100 (~0,99 PFLOPS) y B200 (~2,2 PFLOPS), MFU 40 %, 700–1.000 W por GPU, 0,12 €/kWh. El rendimiento de inferencia varía mucho con el tamaño del lote, la cuantización y el tipo de petición.Adaptación del documento HTML aportado. Los escenarios no describen la infraestructura real de un banco. La estimación de energía contempla las GPU; no incluye toda la instalación.
¿Por qué necesita GPU un banco que despliega IA on-premise?
Las GPU aceleran el cálculo paralelo de los modelos. El tamaño del modelo, la memoria de entrenamiento y la demanda de consultas determinan la capacidad necesaria. Un despliegue on-premise sitúa esa infraestructura en centros de datos propios.
Cómo se utiliza en este recurso
Siete estaciones con una carrera CPU/GPU, comparación de despliegues, razones desplegables, calculadoras de entrenamiento, memoria e inferencia, reparto ilustrativo del clúster y tres preguntas.
Alcance y límites
Simulación didáctica adaptada del documento aportado. Los rendimientos, precios, demanda y reparto son supuestos orientativos, no mediciones de un banco ni un presupuesto. El escalado se idealiza con MFU fijo del 40 %. La energía calculada solo contempla GPU. Las referencias de fabricante no validan todos los supuestos. Operar on-premise no garantiza por sí solo seguridad, cumplimiento o menor coste.
Preguntas frecuentes
¿Entrenar e inferir necesitan las mismas GPU?
Ambas tareas utilizan cálculo y memoria, pero entrenar añade gradientes y estados del optimizador. La inferencia depende también de las consultas simultáneas, los tokens y la latencia deseada.
¿Más GPU siempre reducen el tiempo en la misma proporción?
La calculadora usa un escalado idealizado. En la práctica influyen la comunicación entre GPU, la memoria, los datos y la eficiencia del software.